Utf-8
Содержание:
- Макет кодовой страницы
- Кодирование объектов
- Заключение
- Где указать кодировку сайта
- Как это работает?
- [править] Ссылки
- Что такое кодирование (encoding)?
- Немного теории
- Кодировки стандарта UNICODE
- Утилита Over Drive
- Схема кодировки символов
- Альтернативы нет
- UTF-8
- Формы кодирования
- Набор номера
- Библиотека преобразований Unicode-кодировок
- Properties
- Неправильная кодировка результатов из базы данных MySQL
- Недостатки и достоинства
- [править] BOM (сигнатура)
- Область применения
Макет кодовой страницы
В следующей таблице суммируется использование кодовых блоков UTF-8 (отдельных байтов или октетов) в формате кодовой страницы. Верхняя половина (от до ) предназначена для байтов, используемых только в однобайтных кодах, поэтому она выглядит как обычная кодовая страница; Нижняя половина — для байтов продолжения (от до ) и (возможно) ведущих байтов (от до ), и поясняется далее в легенде ниже.
| _0 | _1 | _2 | _3 | _4 | _5 | _6 | _7 | _8 | _9 | _A | _B | _C | _D | _E | _F | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0_ | NUL0000 | SOH00011 | STX00022 | ETX00033 | EOT00044 | ENQ00055 | ACK00066 | BEL00077 | BS00088 | HT00099 | LF000A10 | VT000B11 | FF000C12 | CR000D13 | SO000E14 | SI000F15 |
| 1_ | DLE001016 | DC1001117 | DC2001218 | DC3001319 | DC4001420 | NAK001521 | SYN001622 | ETB001723 | CAN001824 | EM001925 | SUB001A26 | ESC001B27 | FS001C28 | GS001D29 | RS001E30 | US001F31 |
| 2_ | SP002032 | !002133 | «002234 | #002335 | $002436 | %002537 | &002638 | ‘002739 | (002840 | )002941 | *002A42 | +002B43 | ,002C44 | —002D45 | .002E46 | 002F47 |
| 3_ | 003048 | 003149 | 003250 | 003351 | 003452 | 003553 | 003654 | 003755 | 003856 | 003957 | 003A58 | ;003B59 | <003C60 | =003D61 | >003E62 | ?003F63 |
| 4_ | @004064 | A004165 | B004266 | C004367 | D004468 | E004569 | F004670 | G004771 | H004872 | I004973 | J004A74 | K004B75 | L004C76 | M004D77 | N004E78 | O004F79 |
| 5_ | P005080 | Q005181 | R005282 | S005383 | T005484 | U005585 | V005686 | W005787 | X005888 | Y005989 | Z005A90 | 005B91 | \005C92 | 005D93 | ^005E94 | _005F95 |
| 6_ | `006096 | a006197 | b006298 | c006399 | d0064100 | e0065101 | f0066102 | g0067103 | h0068104 | i0069105 | j006A106 | k006B107 | l006C108 | m006D109 | n006E110 | o006F111 |
| 7_ | p0070112 | q0071113 | r0072114 | s0073115 | t0074116 | u0075117 | v0076118 | w0077119 | x0078120 | y0079121 | z007A122 | {007B123 | |007C124 | }007D125 | ~007E126 | DEL007F127 |
| 8_ | •+00128 | •+01129 | •+02130 | •+03131 | •+04132 | •+05133 | •+06134 | •+07135 | •+08136 | •+09137 | •+0A138 | •+0B139 | •+0C140 | •+0D141 | •+0E142 | •+0F143 |
| 9_ | •+10144 | •+11145 | •+12146 | •+13147 | •+14148 | •+15149 | •+16150 | •+17151 | •+18152 | •+19153 | •+1A154 | •+1B155 | •+1C156 | •+1D157 | •+1E158 | •+1F159 |
| A_ | •+20160 | •+21161 | •+22162 | •+23163 | •+24164 | •+25165 | •+26166 | •+27167 | •+28168 | •+29169 | •+2A170 | •+2B171 | •+2C172 | •+2D173 | •+2E174 | •+2F175 |
| B_ | •+30176 | •+31177 | •+32178 | •+33179 | •+34180 | •+35181 | •+36182 | •+37183 | •+38184 | •+39185 | •+3A186 | •+3B187 | •+3C188 | •+3D189 | •+3E190 | •+3F191 |
| 2-byteC_ | 0000192 | 0040193 | Latin0080194 | Latin00C0195 | Latin0100196 | Latin0140197 | Latin0180198 | Latin01C0199 | Latin0200200 | IPA0240201 | IPA0280202 | IPA02C0203 | accents0300204 | accents0340205 | Greek0380206 | Greek03C0207 |
| 2-byteD_ | Cyril0400208 | Cyril0440209 | Cyril0480210 | Cyril04C0211 | Cyril0500212 | Armeni0540213 | Hebrew0580214 | Hebrew05C0215 | Arabic0600216 | Arabic0640217 | Arabic0680218 | Arabic06C0219 | Syriac0700220 | Arabic0740221 | Thaana0780222 | N’Ko07C0223 |
| 3-byteE_ | Indic0800*224 | Misc.1000225 | Symbol2000226 | Kana, CJK3000227 | CJK4000228 | CJK5000229 | CJK6000230 | CJK7000231 | CJK8000232 | CJK9000233 | AsianA000234 | HangulB000235 | HangulC000236 | HangulD000237 | PUAE000238 | FormsF000239 |
| 4‑byteF_ | SMP, SIP10000*240 | 40000241 | 80000242 | SSP, SPUAC0000243 | SPUA-B100000244 | 140000245 | 180000246 | 1C0000247 | 5-byte200000*248 | 5-byte1000000249 | 5-byte2000000250 | 5-byte3000000251 | 6-byte4000000*252 | 6-byte40000000253 | 254 | 255 |
Оранжевые ячейки с большой точкой являются байтами продолжения. Шестнадцатеричное число, указанное после знака «+», представляет собой значение шести бит, которые они добавляют.
Белые ячейки — это ведущие байты для последовательности из нескольких байтов, длина показана слева от строки. Текст показывает блоки Unicode, закодированные последовательностями, начинающимися с этого байта, а шестнадцатеричная кодовая точка, показанная в ячейке, является самым младшим символьным значением, закодированным с использованием этого старшего байта.
Красные клетки никогда не должны появляться в действительной последовательности UTF-8. Первые два (C0 и C1) могли использоваться только для недопустимого «чрезмерного кодирования» символов ASCII (то есть, пытаясь закодировать 7-битное значение ASCII между 0 и 127, используя два байта вместо одного, см. Ниже). Оставшиеся красные ячейки указывают ведущие байты последовательностей, которые могут только кодировать числа, превышающие предел 0x10FFFF в Юникоде, или которые также никогда не использовались в исходном проекте для 31 бита (FE и FF).
Розовые ячейки являются ведущими байтами для последовательности из нескольких байтов, из которых допустимы некоторые, но не все возможные последовательности продолжения. E0 и F0 могут начинать сглаженные кодировки, в этом случае отображается самая низкая незашифрованная кодовая точка, помеченная звездочкой «*». F4 может запускать кодовые точки более 0x10FFFF, которые являются недопустимыми. ED может начать кодирование суррогатной половины, которая не может быть закодирована в UTF-16 и также недействительна.
Кодирование объектов
Для кодирования объектов в стандартной библиотеке чуть меньше пакетов. Но, на практике, этих пакетов оказывается более, чем достаточно.
Если вы только не провели последние 10 лет в танке, то наверняка заметили, что JSON стал форматом для кодирования объектов по умолчанию. Как уже упоминалось ранее, у JSON есть свои недостатки, но его очень просто использовать и его реализация есть почти во всех языках, поэтому и огромная популярность. Пакет encoding/json предоставляет отличную поддержку этого формата, и, также, в Go есть сторонние, более быстрые, реализации парсеров, такие как ffjson.
И хотя JSON стал доминирующим протоколом обмена между машинами, формат CSV всё еще остается популярным для экспорта данных для людей. Пакет encoding/csv предоставляет хороший интерфейс для работы с табличными данными в этом формате.
Если вы работете с системами, написанными в районе 2000-х, наверняка вам понадобится работать с XML. Пакет encoding/xml предоставляет интерфейс в SAX-стиле для дополнительного основанного на тэгах кодирования/декодирования, похожий на аналогичный пакет для json. Если вам нужны более сложные манипуляции и штуки вроде DOM, XPath, XSD и XSLT, тогда вам, наверное нужно использовать libxml2 через cgo.
У Go также есть свой собственный формат для потокового кодирования — gob. Этот пакет используется в net/rpc для реализации удаленного вызова процедур между Go сервисами. Gob прост в использовании, но он не поддерживается в других языках. gRPC выглядит как более популярная альтернатива если вам нужен кросс-языковой инструмент.
И в заключение, есть пакет encoding/asn1. Документация по нему скромная и единственная ссылка ведёт на 25 страничную стену текста — введение для новичков в ASN.1. ASN.1 это сложная схема кодировки, которая используется, в основном X.509 сертификами в SSL/TLS.
Заключение
Кодирование даёт фундамент для придания логической структуры сырым байтам. Без него у нас бы не было ни строк, ни стркутур данных, ни баз данных или хоть сколько нибудь полезных приложений. То, что кажется простой концепцией, на самом деле имеет богатую историю реализаций и огромный набор компромиссов.
В этой статье мы рассмотрели различные реализации кодировок, реализованных в стандартной библиотеке и некоторых их компромиссы. Мы увидели, как эти пакеты для работы с базовыми типами и объектами построены на нашем понимании работы с байтами и потоками байт в Go. В следующих статьях мы заглянем глубже в эти пакеты и посмотрим, как их использовать в контексте реальных приложений.
Где указать кодировку сайта
Если проблема возникла на вашем сайте, способ исправления зависит от вида сайта. Для одностраничника достаточно указать кодировку в мета-теге страницы, а для большого сайта есть разные варианты:
- кодировка в мета-теге;
- кодировка в .htaccess;
- кодировка документа;
- кодировка в базе данных MySQL.
Кодировка в мета-теге
Добавьте указание кодировки в head файла шаблона сайта.
При создании документа HTML укажите тег meta в начале в блоке head. Некоторые браузеры могут не распознать указание кодировки, если оно будет ниже.
Мета-тег может выглядеть так:
или так:
В HTML5 они эквивалентны.
Тег кодировки в HTML
В темах WordPress обычно тег «charset» с кодировкой указан по умолчанию, но лучше проверить.
Кодировка в файле httpd.conf
Инструкции для сервера находятся в файле httpd.conf, обычно его можно найти на пути «/usr/local/apache/conf/».
Если вам нужно сменить кодировку Windows-1251 на UTF-8, замените строчку «AddDefaultCharset windows-1251» на «AddDefaultCharset utf-8».
Убедитесь, что сервер не передает HTTP-заголовки с конфликтующими кодировками.
Кодировка в .htaccess
Добавьте кодировку в файл .htaccess:
- Откройте панель управления хостингом.
- Перейдите в корневую папку сайта.
- В файле .htaccess добавьте в самое начало код:
- для указания кодировки UTF-8 — AddDefaultCharset UTF-8;
- для указания кодировки Windows-1251 — AddDefaultCharset WINDOWS-1251.
- Перейдите на сайт и очистите кэш браузера.
Кодировка документа
Готовые файлы HTML важно сохранять в нужной кодировке сайта. Узнать текущую кодировку файла можно через Notepad++: откройте файл и зайдите в «Encoding»
Меняется она там же: чтобы сменить кодировку на UTF-8, выберите «Convert to UTF-8 without BOOM». Нужно выбрать «без BOOM», чтобы не было пустых символов.
Кодировка Базы данных
Выбирайте нужную кодировку сразу при создании базы данных. Распространенный вариант — «UTF-8 general ci».
Где менять кодировку у БД:
- Кликните по названию нужной базы в утилите управления БД phpMyAdmin и откройте ее.
- Кликните на раздел «Операции»:
- Введите нужную кодировку для базы данных MySQL:
- Перейдите на сайт и очистите кэш.
С новой БД проще, но если вы меняете кодировку у существующей базы, то у созданных таблиц и колонок заданы свои кодировки, которые тоже нужно поменять.
Для всех таблиц, колонок, файлов, сервера и вообще всего, что связано с сайтом, должна быть одна кодировка.
Проблема может не решиться, если все дело в кодировке подключения к базе данных. Что делать:
- Подключитесь к серверу с правами mysql root пользователя:mysql -u root -p
- Выберите нужную базу:USE имя_базы;
- Выполните запрос:SET NAMES ‘utf8’;
Если вы хотите указать Windows-1251, то пишите не «utf-8», а «cp1251» — обозначение для кодировки Windows-1251 у MySQL.
Чтобы установить UTF-8 по умолчанию, откройте на сервере my.cnf и добавьте следующее:
Вы когда-нибудь сталкивались с проблемами кодировки на сайте?
Как это работает?
Смысл использования символов из таблицы UTF8 заключается в том, что у вас в компьютере уже есть все необходимые знаки и ваш браузер может с лёгкостью их отобразить, нужно только знать их специальный код.
Например, символ стрелочка вверх в UTF8 записывается так ↑
Вы можете скопировать эту последовательность знаков и вставить себе в HTML страницу как обычный текст.
После этого у вас на сайте вместо этого набора знаков появится графическое изображение стрелочки. Удобно, не правда ли!?
И не нужно подключать никаких дополнительных шрифтов на ваш сайт ради вставки нескольких символов, а так же готовить и вставлять графические изображения.
Если вы создаёте свою HTML страницу в кодировке Windows-1251 или ещё какой-то другой то коды дынных символов не буду срабатывать, они отображаются только в кодировке UTF8.
Таблица символов UTF8 (Unicode) включает в себя тысячи, а то миллионы различных знаков.
Чтобы вам не приходилось пересматривать огромные таблицы в поисках нужного значка я выбрала наиболее интересные и полезные из них и разбила их по группам.
[править] Ссылки
- UTF-8: Кодирование и декодирование на habrahabr
- Compatibility Encoding Scheme for UTF-16: 8-Bit (CESU-8)
- Полное описание стандарта Unicode
| UTF-8 относится к теме «Аббревиатуры» | ||||||||||||
|
Что такое кодирование (encoding)?
В программировании нередко для простых концепций используются замудрёные слова. Даже больше того — часто для одной концепции существует несколько замудрёных слов. Кодирование (encoding) это одно из таких слов. Иногда оно называется сериализацией(serialization) или маршалинг (marshaling) — что означет одно и тоже: добавление логической структуры сырым байтам.
В стандартной библиотеке Go мы используем термины кодирование (encoding) и маршалинг (marshaling) для двух разных, но связанных идей. Encoder в Go это объект, который добавляет логическую структуру на поток байт, в то время как marshaling работает с ограниченным набором байт в памяти.
Например, в пакете encoding/json есть и для работы с и потоками соответственно. И также в этом пакете мы видим и для записи и чтения байт из слайса.
Немного теории
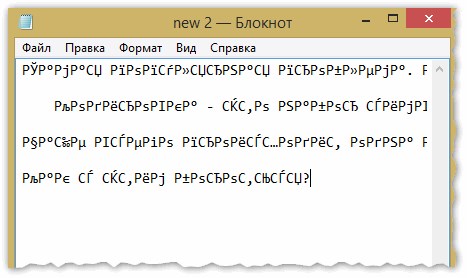
Любой документ на компьютере или в интернете, как я уже сказал, хранится в виде двоичного кода. К примеру, если вы используете кодировку ASCII, то буква «К» будет записана как 10001010, а windows 1251 под этим числом скрывается символ – Љ. В итоге, если браузер или программа обратится к другой таблице и считает вместо ASCII коды windows 1251, то читатель увидит совершенно непонятные ему символ.
Логичен вопрос, нафига было придумывать множество таблиц с кодами? Дело в том, что помимо русского алфавита существует еще и английский, немецкий, китайский. По некоторым подсчетам, существует около 200 000 символов. Хотя, я не очень доверяю этой статистике, вспоминая про японский.
Не забывайте, что для заглавной и строчной буквы нужно придумать свой код, есть запятые, тире и так далее.
Чем больше в таблице символов, тем длиннее код каждого из них, а значит и вес документа становится больше.

Представьте, если бы одна книга весила 4 Гб! Она бы очень долго загружалась, занимала все свободное место на компьютере. Решение о скачивании представлялось бы делом нелегким.
Если вспомнить о сайтах, то вообще страшно подумать, что бы произошло. Каждая страничка открывалась даже на скоростном оптоволокне по часу с лишним! Думаю, мобильные телефоны можно было бы смело выкидывать. Пользоваться ими на улице даже с 4G? Сомневаюсь.
По этим причинам каждый программист в свое время старался придумать свою таблицу символов. Чтобы было удобно для использования и вес сохранялся оптимальным.
Microsoft, к примеру, для русскоязычного сегмента создали windows-1251. В ней, конечно же, есть свои достоинства и недостатки. Как и у любого другого продукта.
Сейчас уже, лишь 2% всех страниц в интернете написано на 1251. Большинство веб-мастеров используют UTF-8. Почему так?
Кодировки стандарта UNICODE
Юникод (англ. Unicode) — стандарт кодирования символов, позволяющий представить знаки почти всех письменностей мира, и специальных символов. Представляемые в юникоде символы кодируются целыми числами без знака. Юникод имеет несколько форм представления символов в компьютере: UTF-8, UTF-16 (UTF-16BE, UTF-16LE) и UTF-32 (UTF-32BE, UTF-32LE). (Англ. Unicode transformation format — UTF).UTF-8 — это в настоящее время распространённая кодировка, которая нашла широкое применение в операционных системах и веб-пространстве. Текст, состоящий из символов Unicode с номерами меньше 128 (область с кодами от U+0000 до U+007F), содержит символы набора ASCII с соответствующими кодами. Далее расположены области знаков различных письменностей, знаки пунктуации и технические символы. Под символы кириллицы выделены области знаков с кодами от U+0400 до U+052F, от U+2DE0 до U+2DFF, от U+A640 до U+A69F.
Кодировка UTF-8 является универсальной и имеет внушительный резерв на будущее. Это делает ее наиболее удобной кодировкой для использования в интернете.
HTML Символы
Кодирование URL
Утилита Over Drive
Мощное приложение для AMD 64. Программа бесплатная.
Страница загрузки приложения
Сразу же после первого запуска программы всплывает диалоговое окно, которое предупреждает пользователя о том, что он несет полную ответственность за все совершенные в программе действия, которые могут привести к поломке процессора.
После соглашения с предоставленной информацией появится главное окно программы.
Главное окно утилиты OverDrive
Слева найдите пункт, который называется Clock Voltage;
Панель инструментов приложения
- Внимательно изучите появившееся окно. Первая колонка данных – это тактовая частота каждого доступного ядра микропроцессора. Вторая вкладка — порядковый множитель ядра, это число и нужно изменить;
- Чтобы настроить множитель, необходимо нажать на кнопку Контроль скорости. Она выделена зеленым цветом на рисунке ниже. Затем отрегулируйте ползунки.
Порядок действий для разгона микропроцессора с помощью программы OverDrive
Схема кодировки символов
Схема кодировки символов состоит из формы кодирования символов и способа побайтного расположения единиц кода. Для определения схемы кодирования стандартом Юникода предусмотрено использование начальной метки порядка байтов (BOM, Byte order mark).
При включении BOM в UTF-8 функция метки ограничивается только указанием на использование формы кодирования. Проблемы определения порядка байтов у UTF-8 нет, так как её размер единицы кодирования равен одному байту. Использование BOM для данной формы кодирования не является ни обязательным, ни рекомендуемым. BOM может встречаться в текстах, конвертированных из других кодировок, использующих метку порядка байтов, или для сигнатуры кодировки UTF-8. Представляет собой последовательность из 3 байтов EF16 BB16 BF16.

Альтернативы нет
В условиях глобализации, когда политические и языковые границы стираются, наборы символов, которые имеют местные особенности, становятся малопригодными. Юникод является единственным набором символов с поддержкой всех локализаций. А UTF-8 – пример правильной реализации Юникода, которая:
- поддерживает широкий диапазон инструментальных средств, в том числе совместимость с кодировкой ASCII;
- обладает устойчивостью к искажению данных;
- проста и эффективна при обработке;
- не зависит от платформы.
С появлением UTF-8 дискуссии о том, какая форма кодирования или набор символов лучше, стали бессмысленны.
UTF-8
UTF-8-это код переменной длины. Некоторые символы требуют 1 байт, некоторые требуют 2, Некоторые 3 и некоторые 4. Байты для каждого символа просто записываются один за другим как непрерывный поток байтов.
в то время как некоторые символы UTF-8 могут быть длиной 4 байта, UTF-8 невозможно закодировать 2^32 символа. Это даже не близко. Я попытаюсь объяснить причины этого.
программное обеспечение, которое читает поток UTF-8, просто получает последовательность байтов — как оно должно решить, следующие 4 байта-это один 4-байтовый символ, или два 2-байтовых символа, или четыре 1-байтовых символа (или какая-то другая комбинация)? В основном это делается путем решения, что определенные 1-байтовые последовательности не являются допустимыми символами, а некоторые 2-байтовые последовательности не являются допустимыми символами и т. д. Когда эти недопустимые последовательности появляются, предполагается, что они являются частью больше последовательности.
вы видели совсем другой пример этого, я уверен: это называется побегом. Во многом языки программирования решено, что символ в исходном коде строки не переводится на любой допустимый символ в «скомпилированной» форме строки. Когда \ находится в источнике, предполагается, что он является частью более длинной последовательности, например или
Обратите внимание, что является недопустимой 2-символьной последовательностью и является недопустимой 3-символьной последовательностью, но является допустимой 4-символьной последовательностью
в основном, есть компромисс между наличием многих характеры и иметь более короткие характеры. Если вы хотите 2^32 символов, они должны быть в среднем длиной 4 байта. Если вы хотите, чтобы все ваши символы были 2 байта или меньше, то вы не можете иметь более 2^16 символов. UTF-8 дает разумный компромисс: все ASCII символы (ASCII от 0 до 127) даны 1-байтовые представления, что отлично подходит для совместимости, но разрешено гораздо больше символов.
как и большинство кодировок переменной длины, включая виды побега последовательности, показанные выше, UTF-8 является мгновенная код. Это означает, что декодер просто читает байт за байтом, и как только он достигает последнего байта символа ,он знает, что такое символ (и он знает, что это не начало более длинного символа).
например, символ » A » представлен с использованием байта 65, и нет двух/трех/четырехбайтовых символов, первый байт которых равен 65. Иначе декодер не смог бы сказать. эти символы, кроме «А», за которыми следует что-то еще.
но UTF-8 ограничен еще больше. Это гарантирует, что кодировка более короткого символа никогда не появится в любом месте в кодировке более длинного символа. Например, ни один из байтов в 4-байтовом символе не может быть 65.
поскольку UTF-8 имеет 128 различных 1-байтовых символов (значения которых равны 0-127), все 2, 3 и 4-байтовые символы должны состоять исключительно из байтов в диапазоне 128-256. Это большое ограничение. Однако он позволяет строковым функциям, ориентированным на байты, работать практически без изменений. Например, C функция всегда работает так, как ожидалось, если ее входы являются допустимыми строками UTF-8.
Формы кодирования
Компьютеры оперируют числами не просто как абстрактными математическими объектами, а как комбинациями единиц хранения и обработки информации фиксированного размера – байтов и 32-разрядных слов. Стандарт кодировки должен это учитывать при определении способа представления символов числами.
В компьютерных системах целые числа хранятся в ячейках памяти размером 8 бит (1 байт), 16 или 32 бит. Каждая форма кодирования Юникода определяет, какая последовательность ячеек памяти представляет целое число, соответствующее конкретному символу. В стандарте представлены три различные формы кодирования символов Юникода: 8, 16 и 32-битными блоками. Соответственно, они носят название UTF-8, UTF-16 и UTF-32. Название UTF расшифровывается как формат преобразования Юникода. Каждая из трёх форм кодирования является равноправным средством представления символов Юникода, имеет преимущества в различных областях применения.
Данные кодировки могут быть использованы для представления всех символов стандарта Юникод. Таким образом, они полностью совместимы для решений, по разным причинам использующих разные формы кодирования. Каждая кодировка может быть однозначно преобразована в любую из двух других без потери данных.

Набор номера
Библиотека преобразований Unicode-кодировок
В сопутствующий этой статье пакет исходного кода включен пример компилируемого C++-кода. Это повторно используемый код, без ошибок компилируемый в Visual C++ при уровне предупреждений 4 (/W4) в 32- и 64-разрядных сборках. Он реализован как библиотека C++ в виде только заголовочных файлов. По сути, этот модуль преобразования Unicode-кодировок состоит из двух заголовочных файлов: utf8except.h и utf8conv.h. Первый содержит определение C++-класса исключения, используемого для уведомления об ошибке при преобразованиях Unicode-кодировок. Второй реализует собственно функции преобразования Unicode-кодировок.
Заметьте, что utf8except.h содержит только кросс-платформенный C++-код; это делает возможным захват исключения при преобразовании кодировки UTF-8 в любых местах ваших проектов на C++, включая те части кода, которые не специфичны для Windows. Напротив, utf8conv.h содержит C++-код, специфичный для Windows, поскольку он напрямую взаимодействует с границей Win32 API.
Для повторного использования этого кода в ваших проектах просто включайте директивой #include эти заголовочные файлы. Сопутствующий пакет исходного кода содержит дополнительный файл, реализующий некоторые наборы тестов.
Properties
|
Gets an encoding for the ASCII (7-bit) character set. |
|
|
Gets an encoding for the UTF-16 format that uses the big endian byte order. |
|
|
When overridden in a derived class, gets a name for the current encoding that can be used with mail agent body tags. |
|
|
When overridden in a derived class, gets the code page identifier of the current Encoding. |
|
|
Gets or sets the DecoderFallback object for the current Encoding object. |
|
|
Gets the default encoding for this .NET implementation. |
|
|
Gets or sets the EncoderFallback object for the current Encoding object. |
|
|
When overridden in a derived class, gets the human-readable description of the current encoding. |
|
|
When overridden in a derived class, gets a name for the current encoding that can be used with mail agent header tags. |
|
|
When overridden in a derived class, gets a value indicating whether the current encoding can be used by browser clients for displaying content. |
|
|
When overridden in a derived class, gets a value indicating whether the current encoding can be used by browser clients for saving content. |
|
|
When overridden in a derived class, gets a value indicating whether the current encoding can be used by mail and news clients for displaying content. |
|
|
When overridden in a derived class, gets a value indicating whether the current encoding can be used by mail and news clients for saving content. |
|
|
When overridden in a derived class, gets a value indicating whether the current encoding is read-only. |
|
|
When overridden in a derived class, gets a value indicating whether the current encoding uses single-byte code points. |
|
|
Gets an encoding for the Latin1 character set (ISO-8859-1). |
|
|
When overridden in a derived class, returns a span containing the sequence of bytes that specifies the encoding used. |
|
|
Gets an encoding for the UTF-16 format using the little endian byte order. |
|
|
Gets an encoding for the UTF-32 format using the little endian byte order. |
|
|
Obsolete. Gets an encoding for the UTF-7 format. |
|
|
Gets an encoding for the UTF-8 format. |
|
|
When overridden in a derived class, gets the name registered with the Internet Assigned Numbers Authority (IANA) for the current encoding. |
|
|
When overridden in a derived class, gets the Windows operating system code page that most closely corresponds to the current encoding. |
Неправильная кодировка результатов из базы данных MySQL
Если ваш сайт состоит из статической части (шаблон) и динамической, которая формируется из данных, получаемых из базы данных, то может возникнуть ситуация, когда часть сайта имеет правильную кодировку, а другая часть сайта имеет неправильную. В этом случае бесполезно менять настройки веб-сервера – поскольку всё равно часть страницы будет иметь неправильную кодировку.
Нужно начать с определения кодировки ваших таблиц. Можно посмотреть в phpMyAdmin:

Обратите внимание на столбец «Сравнение», запись «utf8_unicode_ci» означает, что используется кодировка UTF-8.
Можно подключиться к СУБД MySQL и проверить кодировку таблиц без phpMyAdmin. Для этого:
mysql -u root -p
Если вы забыли имя базы данных, то выполните команду:
SHOW DATABASES;
Предположим, я хочу посмотреть кодировку для таблиц в базе данных information_schema
USE information_schema;
Если вы забыли имя таблиц, выполните:
SHOW TABLES;
Далее выполните команду, в которой имя_таблицы замените на настоящее имя таблицы:
SHOW FULL COLUMNS FROM имя_таблицы;
Например:
SHOW FULL COLUMNS FROM GLOBAL_STATUS;
Вы увидите примерно следующее:

Смотрите столбец Collation. В моём случае там utf8_general_ci, это, как и utf8_unicode_ci, кодировка UTF-8. Кстати, если вы не знаете в чём разница между кодировками utf8_general_ci, utf8_unicode_ci, utf8mb4_general_ci, utf8mb4_unicode_ci, а также какую кодировку выбрать для базы данных MySQL, то посмотрите эту статью.
Теперь, когда мы узнали кодировку (в моём случае это UTF-8), то при каждом подключении к СУБД MySQL нужно выполнять последовательно запросы:
SET NAMES UTF8
SET CHARACTER SET UTF8
SET character_set_client = UTF8
SET character_set_connection = UTF8
SET character_set_results = UTF8
В PHP это можно сделать примерно так:
$this->mysqli = new mysqli($server, $username, $password, $basename);
if ($this->mysqli->connect_error) {
            $this->errorHandler_c->logError(1, 'Connect Error (' . $this->mysqli->connect_errno . ') ' . $this->mysqli->connect_error, $_SERVER );
}
$this->mysqli->query("SET NAMES UTF8");
$this->mysqli->query("SET CHARACTER SET UTF8");
$this->mysqli->query("SET character_set_client = UTF8");
$this->mysqli->query("SET character_set_connection = UTF8");
$this->mysqli->query("SET character_set_results = UTF8");
Обратите внимание, что UTF8 вам нужно заменить на ту кодировку, которая используется для ваших таблиц.
Недостатки и достоинства
UTF-8, в отличие от windows-1251 универсальная кодировка, в ней содержатся буквы различных алфавитов. Существует даже UTF-128, где есть вообще все языки – теулу, суахили, лаосский, мальтийский и так далее.
UTF-8 победнее, буквы занимают в разы меньше места и занимают всего один байт памяти, как и в 1251. В УТФ есть редкие символы из других языков или специальные символы. Они-то и весят по 5-6 байтов, но в документе используются крайне редко.
Эта кодировка более продумана, а потому ее использует большинство приложений по умолчанию. То есть, если вы не указываете программе, какую кодировку вы используете, то первым делом он проверит именно UTF-8 .
Когда вы создаете html документ для сайта, то указываете браузерам на какую таблицу им обращать внимание при расшифровке записей. Для этого необходимо вставить в тег head следующие данные
После символов «charset=» идет либо утф, либо виндовс, как в примере ниже
Для этого необходимо вставить в тег head следующие данные. После символов «charset=» идет либо утф, либо виндовс, как в примере ниже.
<meta http-equiv="Content-Type" content="text/html; charset=utf-8"> |
Если в дальнейшем вы захотите что-то поменять и вставить фразу на албанском, используя эту таблицу расшифровок, то ничего не получится, ведь этого языка кодировка не поддерживает. UTF‑8 без проблем позволит вам это сделать.
Если вас заинтересовало правильное создание сайта, то я могу порекомендовать вам курс Михаила Русакова «Создание и Раскрутка сайта от А до Я».
Он содержит в себе очень много – 256 уроков, затрагивающих HTML, CSS, JavaScript, PHP, MySQL и XML. Помимо языков программирования вы сможете понять как монетизировать сайт, то есть скорее и больше получать прибыль. Один из немногих курсов, в котором было бы так подробно разъяснено все, что нужно.
Сам я вот уже год обучаюсь в школе блоггеров Александра Борисова. Это занимает в разы больше времени, конца и края пока не видно, но зато не менее исчерпывающе и дисциплинирует. Мотивирует продолжать разработку.
Ну а если возникают вопросы, не нужно искать по интернету. Всегда есть грамотный наставник.
Что-то я отошел от темы. Давайте вернемся к кодировкам.
[править] BOM (сигнатура)
Многие программы Windows (включая Блокнот) добавляют байты 0xEF, 0xBB, 0xBF в начале любого документа, сохраняемого как UTF-8.
Это метка порядка байтов (англ. Byte Order Mark, BOM), также её часто называют сигнатурой (соответственно, UTF-8 и UTF-8 with Signature). По наличию сигнатуры программы могут автоматически определить, является ли файл закодированным в UTF-8, однако файлы с такой сигнатурой могут некорректно обрабатываться старыми программами, в частности xml-анализаторами. Такие редакторы, как Notepad++, Notepad2 и Kate, позволяют явно указывать, следует ли добавлять сигнатуру при сохранении UTF-файлов.
Например: В файле записана одна латинская буква «a».
- Если кодировка этого файла UTF-8 with Signature, то он будет содержать: 0xEF 0xBB 0xBF 0x61
- Если кодировка этого файла UTF-8 (без сигнатуры), то он будет содержать: 0x61
Если считывающая программа не поддерживает BOM, то эти три байта успешно раскодируются в один Unicode-символ 0xFEFF. Это не разрывающий слова пробел нулевой ширины и поэтому он может не отобразиться. Этот же символ используется в BOM для кодировок UTF-16 и UTF-32.
Область применения
Кодировке UTF-8 обычно отдаётся предпочтение в протоколе HTML и ему подобным.
XML стал первым стандартом с полной поддержкой кодировки UTF-8. Организации, занимающиеся стандартизацией, тоже её рекомендуют. Проблема поддержки в адресах URL, отличных от ASCII-символов, была решена, когда консорциум W3С и инженерная группа IETF пришли к соглашению о кодировании всех адресов URL исключительно в UTF-8.
Совместимость с ASCII облегчает переход к новому программному обеспечению. С UTF-8 работает большинство текстовых редакторов, в том числе JEdit, Emacs, BBEdit, Eclipse и «Блокнот» операционной системы Windows. Ни одна другая форма кодирования Юникода не может похвалиться такой поддержкой со стороны инструментальных средств.
Преимущество кодировки заключается в том, что она состоит из последовательности байтов. Со строками UTF-8 легко работать в C и других языках программирования. Это единственная форма кодирования, не требующая метки порядка байтов BOM или объявления кодировки в XML.